Hermes - Partie 01 : De OpenClaw à Hermes, présentation et architecture cible
- Bilan d’OpenClaw : fonctionnel mais chronophage à suivre ; bascule vers Hermes Agent (Nous Research).
- Hermes : mémoire à quatre couches, skills auto-générées, sécurité native et support MCP.
- Roger, nouvel agent DevSecOps, ciblera Xen Orchestra via MCP avec un compte en lecture seule.
- Architecture : Podman rootless, Vault, LM Studio sur Mac et GLM (Z.ai), Syncthing et Obsidian ; série en 7 parties.
Introduction
Si vous avez suivi ma série sur OpenClaw, vous savez que j'avais terminé le dernier article sur une note un peu mitigée. Le premier agent it-claw fonctionnait, il surveillait mon cluster Kubernetes en lecture seule, et on pouvait l'interroger depuis Telegram. Mais ça n'avait pas été sans mal.
Entre les changements de configuration d'une version à l'autre et l'accès à la GUI via le mode trusted-proxy qui avait fini par ne plus fonctionner, j'avais passé presque autant de temps à suivre les évolutions d'OpenClaw qu'à construire mon agent.
J'évoquais déjà des alternatives mieux pensées, comme Hermès, et que j'allais devoir faire d’autre tests rapidement. C’est donc l’occasion de réaliser une nouvelle série d’articles, tourner justement sur la création d’un nouvel agent sous Hermes.
L'idée n'est pas de tout jeter. Une bonne partie de ce qui a été construit pour OpenClaw reste valable : la VM dédiée, le compte de service, Podman en mode rootless, SELinux, Vault pour les secrets, NGINX en frontal. On va donc reprendre exactement la même logique, mais en l'adaptant à Hermes et en profitant de l'occasion pour corriger les points faibles que j'avais moi-même relevés.
Autre changement : cette fois-ci, je ne vais pas illustrer la démarche avec Kubernetes. Le nouvel agent, que j’ai baptisé Roger (parce que…), va d'abord s'occuper de ma plateforme de virtualisation à travers Xen Orchestra. Kubernetes reviendra plus tard, au même titre que mon firewall OPNsense et mon routeur MikroTik.
L’objectif est de faire de Roger mon DevSecOps personnel chargé de superviser et de suivre mon home lab au quotidien.
Dans ce premier article, pas de commande. On pose le décor : ce qu'est Hermes, ce qu'il apporte par rapport à OpenClaw, ce que fera Roger, et surtout l'architecture complète que l'on va déployer au fil des sept parties de la série.
Hermes Agent
Historique et grands principes
Cliquez sur l'image pour l'agrandir.
Hermes Agent est un projet open source publié par Nous Research, sous licence MIT. Nous Research fut d’abord un collectif de recherche devenu laboratoire d'IA appliquée, déjà célèbre dans la communauté open-source pour sa famille de grands modèles de langage (LLM) Nous Hermes.
La société est né sur Discord avec la volonté de créer des modèles ouverts, non censurés, centrés sur l'utilisateur et capables de rivaliser avec les géants propriétaires (OpenAI, Anthropic…). Le collectif s'est ensuite structuré en entreprise tout en gardant un ADN très proche de la recherche ouverte et de la décentralisation.
Le projet Hermes se présente comme « l'agent IA qui s'améliore de lui-même » (the self-improving AI agent). Derrière ce slogan un peu marketing, on trouve surtout un agent écrit en Python, très structuré, et pensé pour être exécuté comme un service.
Je trouve important de faire un focus sur sa particularité majeure : sa capacité à s'auto-améliorer. Lorsqu'il résout un problème complexe,Hermes rédige lui-même un fichier Markdown de compétence (skill) pour ne plus avoir à réapprendre la méthode la fois suivante, tout en maintenant une mémoire persistante à 4 couches.
Ce découpage en 4 couches d'Hermes est directement inspiré de la mémoire humaine. C’est une manière de répondre à un problème architectural classique des agents IA : comment se souvenir de tout sur le long terme sans exploser la fenêtre de contexte (le coût en tokens) ni polluer le raisonnement du LLM avec du bruit (le fameux syndrome de context rot).
Au lieu de tout jeter dans une base de données vectorielle opaque (RAG classique), Nous Research a séparé la mémoire selon la nature de l'information
| Couche | Stockage local | Coût en tokens | Rôle principal |
|---|---|---|---|
| 1. Prompt Memory (Les faits critiques) |
MEMORY.md |
Fixe (~800 tokens/session) | Contexte technique immédiat |
| 2. Profil Utilisateur (Le qui) |
USER.md |
Fixe (~500 tokens/session) | Préférences et style de l'humain |
| 3. Session Search (l’archive historique) |
state.db (SQLite FTS5) |
0 (chargé à la demande) | Retrouver une discussion passée |
| 4. Skills (Procédural) (le savoir faire) |
~/.hermes/skills/*.md |
Quasi nul (noms seuls en prompt) | Réutiliser des méthodes complexes |
Cette logique est totalement auditable (markdown et base SQLlite) et économique.
L’écriture de la solution a démarré en juillet 2025 pour une première mise à disposition en février 2026, pour connaitre ensuite un rythme de développement très important.
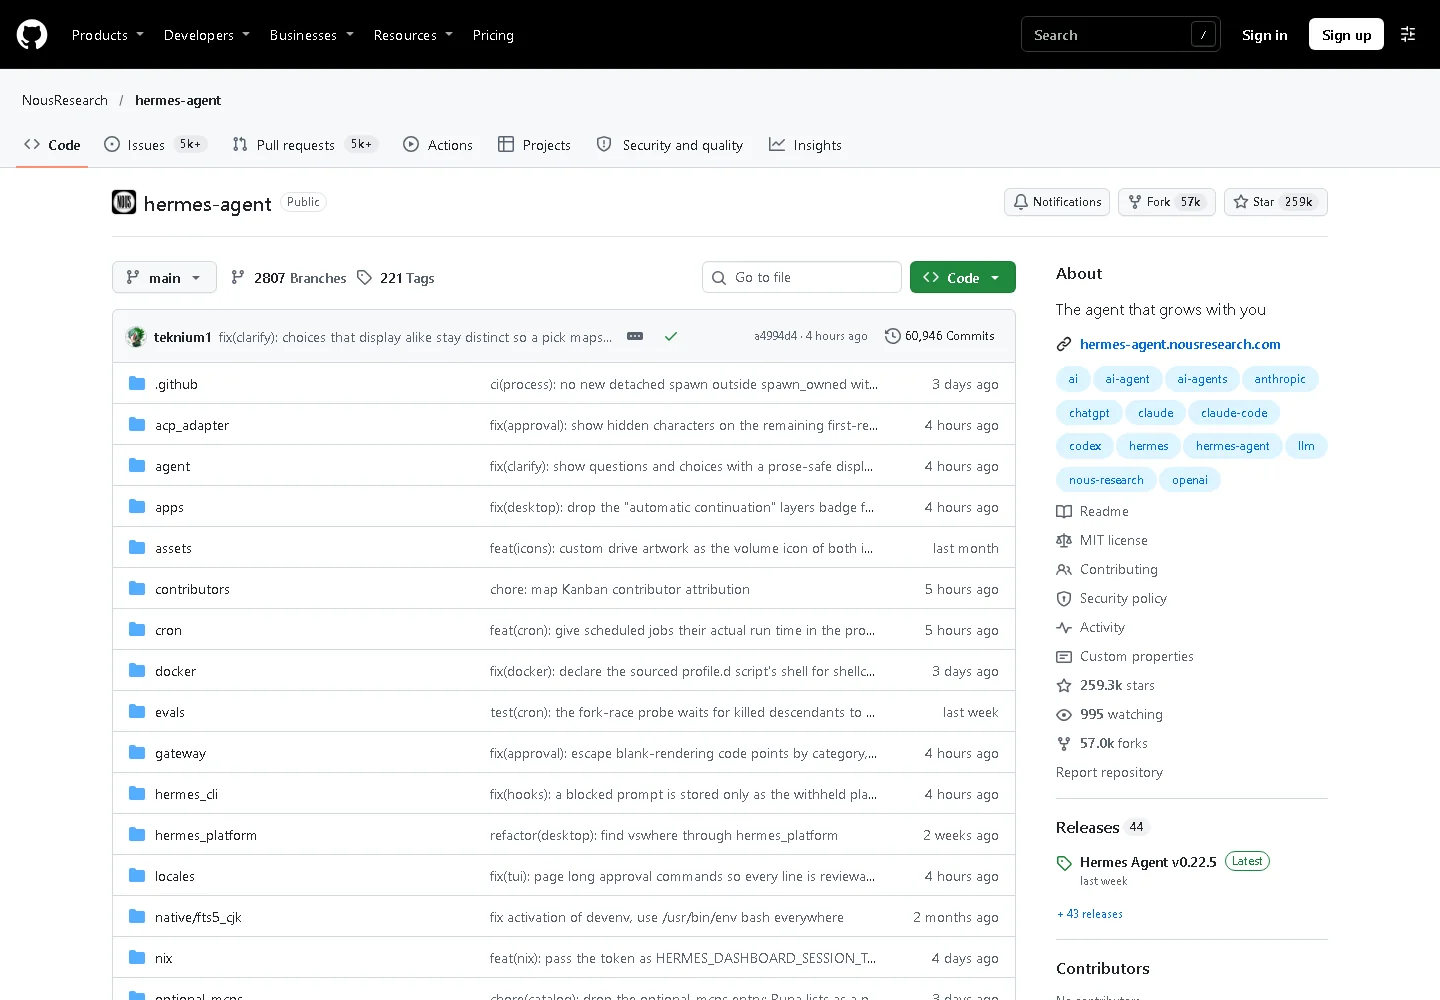
Au moment où j'écris ces lignes, la dernière version est la v0.22.5, publiée le 23 octobre 2026, et le dépôt GitHub dépasse les 250 000 étoiles. Autant dire que la communauté est au rendez-vous.
Cliquez sur l'image pour l'agrandir.
Un point mérite quand même d'être souligné tout de suite : le rythme de sortie est soutenu. Entre le 14 et le 23 octobre, cinq versions se sont succédé (de la v0.22.1 à la v0.22.5). C'est le signe d'un projet vivant, mais c'est aussi exactement le piège dans lequel je suis tombé avec OpenClaw. Les changements peuvent être impactants et suivre les évolutions du projet, surtout dans un contexte de production qui peut s’avérer chronophage.
Fonctionnement
Sur le principe, Hermes fonctionne comme OpenClaw. C'est une « coquille » autour d'un modèle de langage : il ne contient pas d'intelligence en lui-même, il faut lui fournir un accès à un LLM, distant ou local.
Le cycle reste le même : vous envoyez une demande (via Telegram par exemple), Hermes la transmet au LLM avec le contexte de l'agent, le modèle décide d'appeler des outils, Hermes les exécute et renvoie le résultat au modèle, jusqu'à obtenir une réponse. Le triptyque Perception - Décision - Action, décrit dans la première partie de la série OpenClaw, s'applique toujours.
Côté composants, on retrouve une CLI (hermes), une gateway qui reste en écoute et fait le lien avec les messageries (Telegram, Discord, Slack, Signal…), un dashboard web pour consulter la configuration, les sessions et les journaux, et une API compatible OpenAI que l'on n'activera pas.
Toute la configuration d'un agent tient dans un seul répertoire, appelé HERMES_HOME. On y trouve un fichier config.yaml (la configuration), un fichier .env (les secrets), un fichier SOUL.md (la personnalité de l'agent), ainsi que les sessions, la mémoire, les skills, les tâches planifiées et les journaux. C'est beaucoup plus lisible que le gros fichier openclaw.json qui regroupait tout et n'importe quoi.
Point important: Hermes exige un contexte d'au moins 64 000 tokens pour fonctionner en mode agent. En dessous, il refuse tout simplement de démarrer. Cette contrainte va peser lourd dans le choix du modèle local, on y revient un peu plus loin.
Ce qu'Hermes apporte nativement
En plus de la philosophie même de Hermes et de son principe de base, ce qui m'a convaincu de changer, c’est l’intégration native dans Hermes de plusieurs éléments que j’avais dû essayer d’implémenter moi-même avec OpenClaw.
| Besoin | Avec OpenClaw (série précédente) | Avec Hermes |
|---|---|---|
| Restreindre qui parle à l'agent | Allowlist Telegram | Allowlists par plateforme, appairage par code en option |
| Valider une action sensible | Rien : l'agent était en lecture seule, point | Approbation humaine des commandes dangereuses, avec boutons dans Telegram |
| Brancher des outils externes | Binaire kubectl dans l'image |
MCP natif (stdio, HTTP, OAuth, mTLS) avec filtrage outil par outil |
| Plusieurs agents | Un dossier par agent, à la main | Profils natifs, ou un conteneur par agent |
| Tâches planifiées | Heartbeat | Cron intégré, avec livraison vers Telegram ou un fichier |
| Tracer ce que fait l'agent | Hook command-logger | Hooks sur chaque étape, journaux avec masquage des secrets |
| Accès à la GUI | NGINX + trusted-proxy (devenu non fonctionnel) | Dashboard avec authentification native obligatoire |
| Reprendre l'existant | - | Importateur d'agents OpenClaw |
Le MCP (Model Context Protocol), que j'avais présenté dans un article dédié, va remplacer le binaire kubectl d'it-claw. Au lieu de donner un shell à l'agent, on lui donne accès à un serveur qui expose une liste d'outils bien définis, et Hermes permet de choisir lesquels sont autorisés.
Quant à l'importateur OpenClaw (SOUL.md, mémoire, skills…), je ne vais pas l'utiliser : la cible change complètement et je préfère reconstruire proprement. Mais si vous avez déjà un agent OpenClaw qui tourne, c'est une piste à garder en tête.
La sécurité
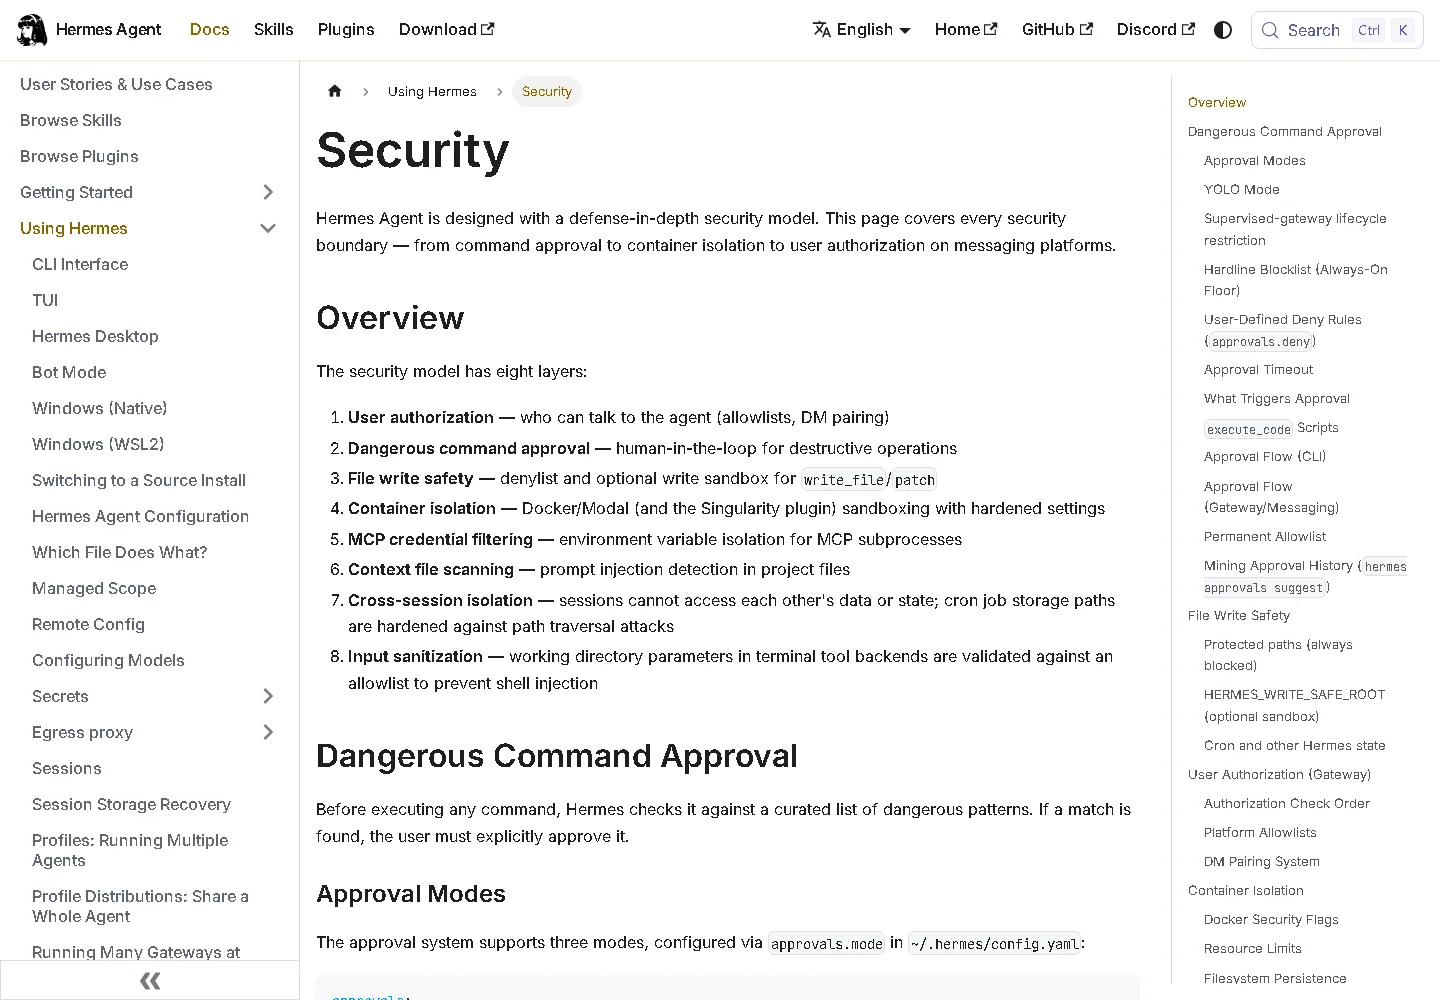
Avec OpenClaw, la sécurité était le gros point noir, et une grande partie de la série consistait à compenser ce que l'outil ne faisait pas. Hermes part sur des bases beaucoup plus saines. Sa documentation décrit un modèle de sécurité en plusieurs couches, dont:
- l'autorisation des utilisateurs : seuls les comptes explicitement autorisés peuvent dialoguer avec l'agent, les autres sont ignorés ;
- l'approbation des commandes dangereuses : en mode manuel, toute commande jugée risquée est suspendue jusqu'à validation humaine, et sans réponse au bout de cinq minutes, c'est un refus ;
- une liste de blocage non contournable (
rm -rfsur la racine, fork bomb, etc.), active quoi qu'on configure ; - une zone d'écriture limitée au répertoire de l'agent, avec des chemins protégés comme le
.env; - le filtrage des variables d'environnement transmises aux sous-processus et aux serveurs MCP, ce qui évite qu'un outil récupère des secrets qui ne le concernent pas ;
- une analyse anti-injection des fichiers de contexte comme le
SOUL.md; - un blocage par défaut des adresses privées pour les outils web, pour éviter que l'agent ne se mette à explorer votre réseau local.
Cliquez sur l'image pour l'agrandir.
Est-ce que ça veut dire qu'on peut installer Hermes n'importe comment ? Évidemment que non. Ce sont des garde-fous applicatifs. Si l’agent dispose d’un compte d’administration sur votre infrastructure, une erreur de configuration ou un modèle mal manipulé peuvent toujours causer des dommages. On garde donc la même philosophie que pour OpenClaw : rootless, secrets dans Vault, moindre privilège sur les cibles. On reste sur une approche à plusieurs niveaux de sécurité.
Roger, un agent Admin OPS et Infra
La mission
Roger sera mon assistant d'administration. Son rôle : suivre l'état de mon infrastructure, m'expliquer ce qu'il observe, me proposer des actions, et documenter tout ça.
Il va commencer par Xen Orchestra, l'interface d'administration de mes hôtes XCP-ng, dont j'ai décrit l'installation dans mon lab V2. Concrètement, Roger devra pouvoir répondre à des questions du type :
- combien de VMs tournent et lesquelles sont arrêtées ?
- Dans quel état est le pool, les hôtes, le stockage ?
- Y a-t-il des alarmes ou des tâches en échec ?
- Est-ce que les sauvegardes de cette nuit se sont bien passées ?
- Quelle VM consomme le plus de CPU ou de mémoire en ce moment ?
À terme, l'objectif est d'étendre son périmètre à mes firewalls OPNsense, à mon routeur MikroTik (RouterOS ) et à mon cluster Kubernetes, comme l'avait fait it-claw. Mais chaque chose en son temps.
L'accès à Xen Orchestra
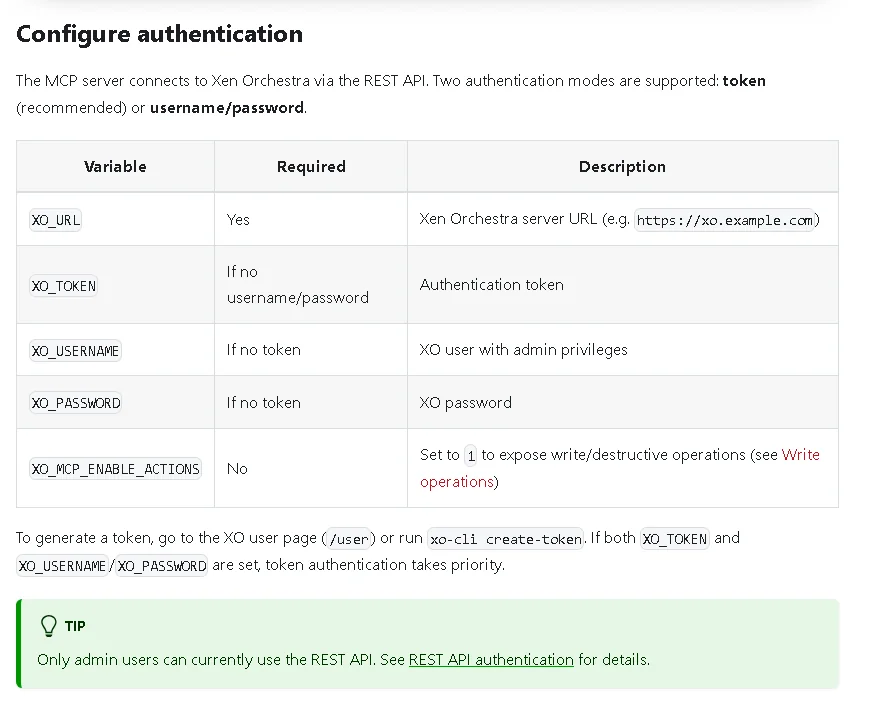
Mon instance Xen Orchestra est installée depuis les sources (commit 70b08) et accessible sur https://prdxcpxor501.coolcorp.priv:8443. Elle expose une API REST, et surtout, Vates fournit un serveur MCP officiel (@xen-orchestra/mcp). C'est l'équivalent de kubectl pour it-claw, en mieux pensé pour un agent.
Ce serveur MCP fonctionne en lecture seule par défaut. Les actions (démarrer, arrêter une VM…) doivent être activées explicitement, et chacune exige alors un jeton de confirmation valable cinq minutes. On peut aussi définir une liste d'actions interdites, et Xen Orchestra dispose d'un interrupteur pour couper tout accès MCP en cas de problème.
Cliquez sur l'image pour l'agrandir.
Seule limite : les métriques de performance (CPU, mémoire, disque) ne sont pas exposées par le MCP. Pour celles-ci, Roger utilisera un petit skill maison qui interroge l'API REST, uniquement en lecture.
Pour le moindre privilège, Roger disposera de son propre compte dans Xen Orchestra, svc-hermes-roger. Ce ne sera pas un administrateur : il sera placé dans un groupe disposant d'un accès en lecture seule sur mes pools XCP-ng, aussi bien dans l'interface web que dans l'API. Le processus de création sera abordé dans la section 5, où nous confirmerons également que le serveur MCP fonctionne correctement avec un compte standard. La documentation de Vates n’est pas entièrement claire à ce sujet, alors je préfère le vérifier dans des conditions réelles.
Sur toute la durée de la série, Roger restera strictement en lecture seule. Lui donner le droit d'agir sur les VMs sera décrit dans le dernier article, mais pas activé. Je préfère d'abord observer son comportement pendant un moment avant de lui confier les clés du camion.
Les cerveaux de Roger
Pourquoi un mix local et cloud
Pour OpenClaw, j'avais fait le choix d'une solution entièrement interne, avec Ollama et Qwen3.5 sur mon PC équipé d'un GPU. Cette fois, je change d'approche et je combine deux sources.
Un modèle local, sur mon MacBook Pro M4 Pro (24 Go de mémoire unifiée). Il sera le modèle par défaut de Roger, pour toutes les questions courantes de supervision et les tâches planifiées. Les données restent chez moi.
Cliquez sur l'image pour l'agrandir.
Un modèle cloud, GLM de Z.ai. Je dispose d'un abonnement GLM Coding Lite, et bonne nouvelle, Hermes Agent fait partie des outils officiellement supportés par cette offre (en « best effort », c'est-à-dire sans garantie de service). Il servira au raisonnement plus lourd : analyse d'incident, diagnostic, synthèse hebdomadaire. Et surtout, il prendra le relais automatiquement si le Mac est éteint.
Cliquez sur l'image pour l'agrandir.
Le local : LM Studio plutôt qu'Ollama
Cliquez sur l'image pour l'agrandir.
Vous vous attendiez sans doute à retrouver Ollama, que j'avais présenté dans un précédent article. Il aurait fonctionné, d'autant qu'il utilise désormais le moteur MLX d'Apple par défaut. J’ai finalement choisi LM Studio pour deux raisons :
- il exige un jeton d’authentification, alors qu’Ollama accepte toutes les requêtes sans distinction. C'était l'une des faiblesses que j'avais soulignées dans la série OpenClaw ;
- il permet de régler finement la taille du contexte par modèle, ce qui est indispensable vu l'exigence des 64 000 tokens d'Hermes.
Côté modèle, je pars sur Qwen3.5 9B au format MLX 8 bits, avec un contexte de 65 536 tokens. Sur 24 Go partagés avec macOS, un modèle de 9 milliards de paramètres laisse de la place pour ce gros contexte, là où un 20 ou 30 milliards deviendraient vites trop juste. La version 4 bits servira de repli si la mémoire sature ; les mesures réelles seront faites dans la partie 04.
LM Studio n'écoutera que localement. Un NGINX installé sur le Mac servira de frontal HTTPS sur llmmac.coolcorp.priv, avec un certificat de ma PKI interne, et le pare-feu de macOS n'acceptera que l'adresse de la VM. Fini le flux en clair vers le modèle local.
Le cloud : GLM, avec ses limites
L'offre Coding Lite donne accès aux modèles glm-5.3 et glm-5.3-flash, avec des quotas en crédits : 2 000 par fenêtre de cinq heures et 10 000 par semaine. D'après mes premiers calculs, c'est suffisant pour du raisonnement à la demande, pas pour faire tourner Roger en permanence sur GLM-5.3. D'où le local par défaut.
La bascule se fera manuellement (en changeant de modèle pour une question complexe), automatiquement via le mécanisme de secours d'Hermes (fallback_providers) si le Mac ne répond pas, ou de façon planifiée en fixant le modèle de chaque tâche programmée.
Il faut cependant être honnête : quand GLM est utilisé, le contexte de la conversation part chez Z.ai, y compris les réponses des outils (noms de VMs, adresses IP internes, extraits de notes). Aucun secret ne doit y transiter, Roger aura une consigne explicite sur ce point, mais l'inventaire de mon infrastructure sortira de chez moi. Personnellement ce n’est pas un problème. En entreprise, tout dépend de votre politique de risque et des contrats éventuels que vous auriez avec des fournisseurs et des offres pro. Pour certain il faudrait sans doute deux agents distincts, l'un purement local, l'autre autorisé à utiliser le cloud sans accès aux outils d'infrastructure.
Architecture retenue
Vue d'ensemble
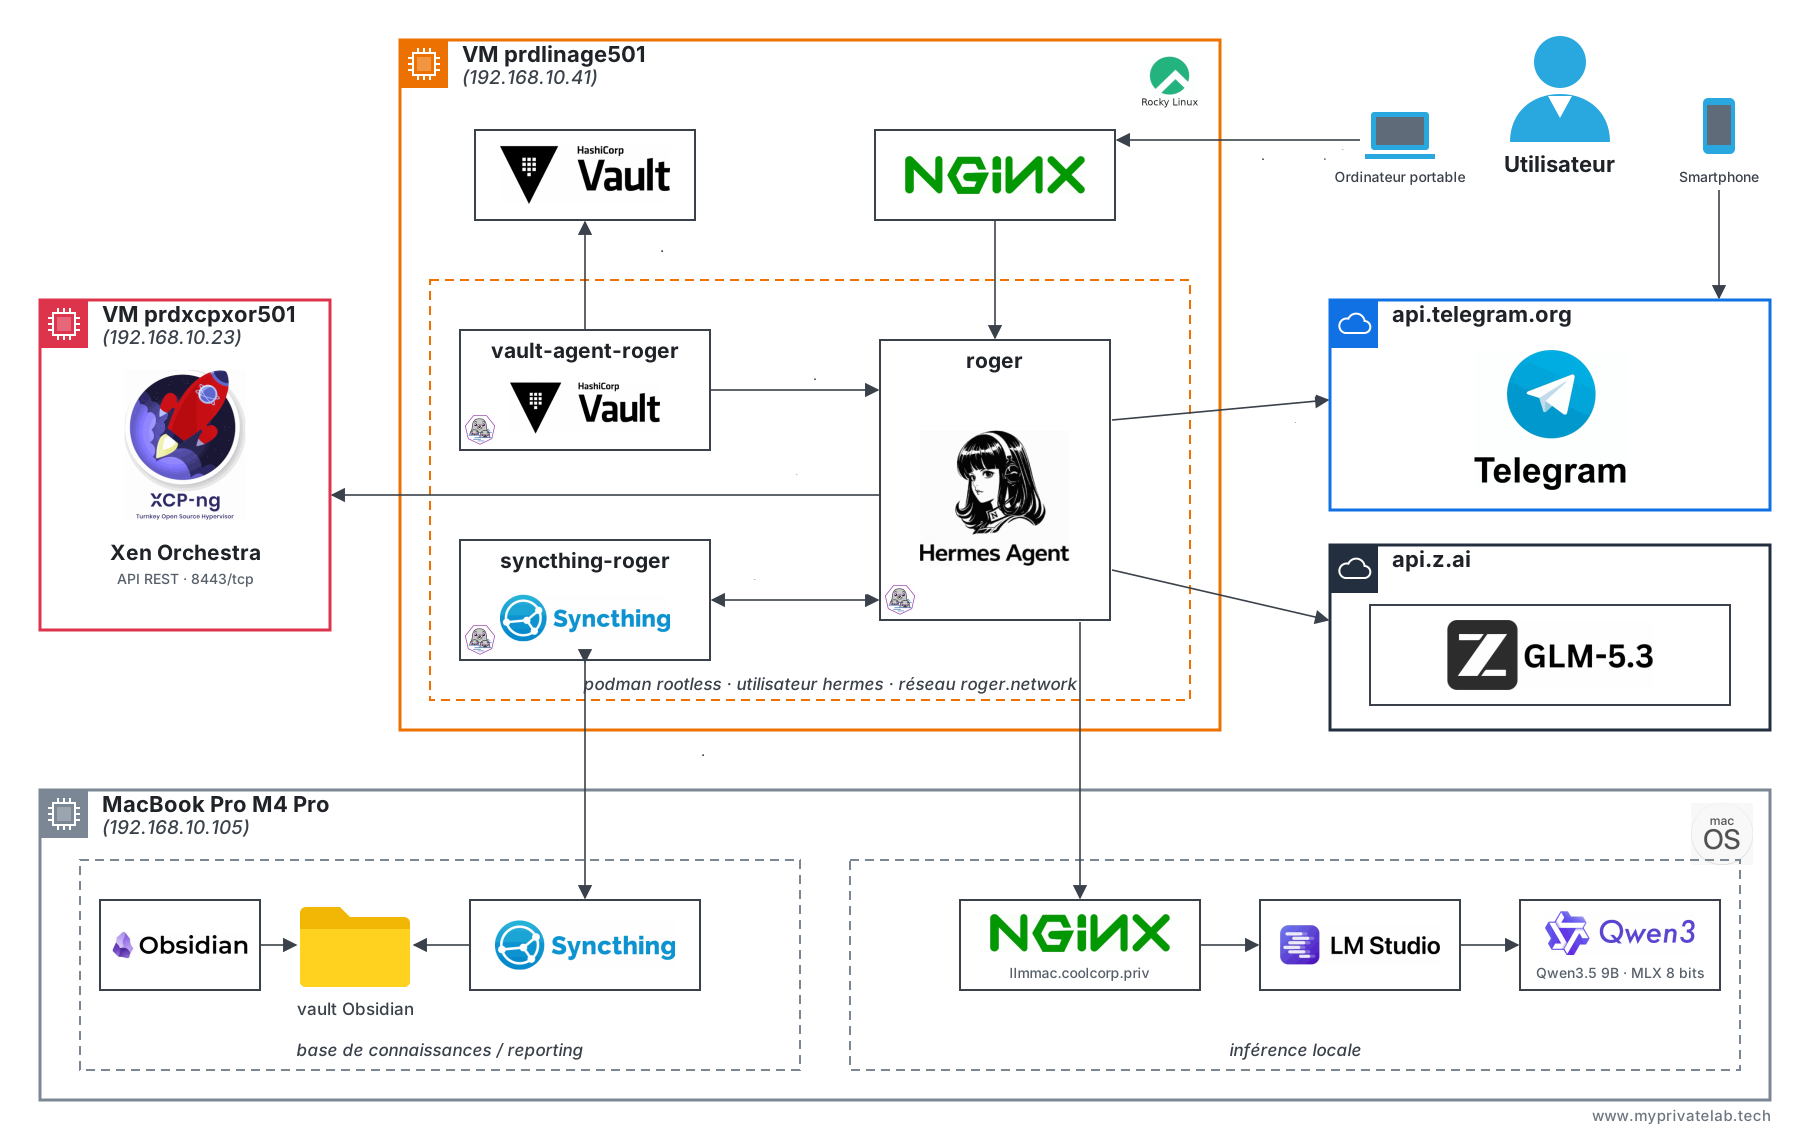
Comme d'habitude, on commence par présenter l'architecture à mettre en place avant de détailler les composants.
Cliquez sur l'image pour l'agrandir.
On reste sur la même VM que pour la série OpenClaw : prdlinage501, adresse 192.168.10.41, exécutée sur XCP-ng. Je l'ai réinstallée avec un Rocky Linux 10 tout neuf, mise à jour. On reviendra sur ces premières opérations dans la partie 02. Elle dispose de 4 vCPU, 80 Go de disque, et je passe la mémoire à 8 Go : l'image Hermes embarque Python, Node.js et Chromium, et 6 Go devenaient un peu justes. SELinux reste en mode enforcing et firewalld actif. Toujours pas d'exposition sur Internet.
Détails des composants
Le compte de service. À l’instar de OpenClaw, tous les éléments de l’agent sont situés dans un compte système dédié, hermes, sans mot de passe et sans sudo, travaillant dans son propre home (/var/lib/hermes). Ce répertoire sert de racine pour toutes les arborescences montées dans les conteneurs.
Podman rootless et les Quadlets. Le moteur de conteneurs reste Podman, en mode rootless, piloté par systemd au travers des Quadlets (le « traducteur » entre Podman et systemd dont je parlais dans la série précédente). Les trois conteneurs de Roger partageront un réseau Podman dédié, roger.network.
Vault. Le coffre-fort reste au cœur du dispositif. Vault 2.2.1 est installé sur la VM, avec un certificat de ma PKI interne et le moteur KV pour stocker les secrets de Roger sous secret/hermes/roger/ : jeton du bot Telegram, clé GLM, jeton LM Studio, token Xen Orchestra et mot de passe du dashboard.
Le sidecar Vault Agent. Comme pour it-claw, un conteneur Vault Agent (vault-agent-roger) s'authentifie auprès de Vault et dépose les secrets dans un dossier qui sert de sas (sink). La différence, c'est qu'Hermes lit ses secrets dans un fichier .env : le sidecar va donc générer directement ce fichier à partir d'un modèle. Petit bonus, l'accès AppRole sera cette fois restreint à l'adresse de la VM et les fichiers d'identifiants ne seront plus lisibles que par leur propriétaire.
L'agent Roger. Le conteneur principal (roger) est construit à partir de l'image officielle nousresearch/hermes-agent:v0.22.5, à laquelle on ajoute le serveur MCP de Xen Orchestra, jq et le certificat de ma CA interne. Il exécute la gateway Hermes, qui fait le lien avec Telegram, et le dashboard web.
Syncthing et Obsidian. C'est la nouveauté de cette série. Je veux que Roger puisse consulter mes procédures et tenir un journal lisible par un humain. Pour ça, j'utilise Obsidian, une application de prise de notes en Markdown. Un « vault » Obsidian (qui n’a rien à voir avec HashiCorp Vault, il ne faut pas le confondre) n’est rien d’autre qu’un dossier de fichiers texte au format markdown. Il sera stocké sur la VM, monté dans le conteneur de Roger, et synchronisé vers mon Mac par Syncthing, un outil de synchronisation open source, chiffré, sans serveur tiers. Roger y lira le référentiel de mes VMs (le rôle de chacune et les règles de placement à respecter), et n'écrira que dans son propre dossier Roger/ (journal d'incidents, rapports quotidiens).
Pour moi c’est une manière d’ajouter encore un niveau de mémoire à Hermes avec laquelle je peux directement agir pour étendre les sources de connaissances de l’agent. Mais on aura l’occasion d’en reparler le moment venu.
NGINX. Il reste en frontal HTTPS pour le dashboard, sur roger.coolcorp.priv. Mais ce n'est plus lui qui gère l'authentification : c'est le dashboard d'Hermes, qui l'impose dès qu'il n'écoute pas uniquement en local.
Telegram. Un bot dédié à Roger, qui ne répondra qu'à mon identifiant. Hermes interroge Telegram en sortie (long polling) : aucun port entrant n'est nécessaire pour ce canal.
Les flux
Voici une vue simplifiée des flux. Hormis l'accès au dashboard et la synchronisation Syncthing, tout part de la VM vers l'extérieur.
| Source | Destination | Port | Protection |
|---|---|---|---|
| Poste admin | NGINX de la VM (dashboard) | 443/tcp | TLS PKI interne + authentification du dashboard |
Conteneur vault-agent-roger |
Vault (VM) | 8200/tcp | TLS + AppRole limité à l'adresse de la VM |
Conteneur roger |
api.telegram.org | 443/tcp sortant | TLS + jeton du bot |
Conteneur roger |
Xen Orchestra | 8443/tcp sortant | TLS PKI interne + token du compte svc-hermes-roger |
Conteneur roger |
Mac (llmmac.coolcorp.priv) | 443/tcp sortant | TLS PKI interne + jeton LM Studio, pare-feu du Mac |
Conteneur roger |
api.z.ai | 443/tcp sortant | TLS + clé GLM |
| Mac (Syncthing) | Syncthing de la VM | 22000/tcp-udp, 21027/udp | TLS Syncthing, appairage par identifiant d'appareil |
L'API compatible OpenAI d'Hermes ne sera pas activée et l'interface de Syncthing ne sera accessible qu'au travers d'un tunnel SSH.
Ce qui change par rapport à OpenClaw
Pour ceux qui ont suivi la série précédente, voici les principales différences :
- Le mapping des utilisateurs. Avec OpenClaw, l'utilisateur du conteneur correspondait côté hôte à un UID exotique (100999), d'où les
podman unshare chownet certains fichiers laissés en 644. Podman permet de faire correspondre directement l'UID 10000 du conteneur au comptehermesde l'hôte. Si cela fonctionne comme prévu (c'est l'un des premiers tests de la partie 02), tous les fichiers appartiendront simplement àhermes. - Un
.envgénéré par Vault Agent au lieu des fichiers de secrets individuels lus par OpenClaw. - L'authentification native du dashboard, qui remplace le mode trusted-proxy.
- Le MCP à la place d'un binaire dans l'image.
- Des garde-fous et un audit natifs (approbations, hooks, journaux), que l'on exploitera dans le dernier article.
- Un frontal TLS authentifié devant le LLM local, au lieu d'un flux HTTP en clair.
Je vais également approfondir l’exploitation en assurant la sauvegarde, la mise à jour, une surveillance légère et la conception d’un modèle réutilisable pour créer d’autres agents (c’était déjà l’objectif avec OpenClaw).
Comme pour la série précédente, je ne garantis pas une solution sans défaut. Certains points restent à valider en conditions réelles et je vous le signalerai à chaque fois.
Plan de la série
La série comptera sept parties :
- Partie 01 : De OpenClaw à Hermes, présentation et architecture cible (vous y êtes).
- Partie 02 : Préparation de l'OS, de Podman rootless et du compte hermes, avec un premier lancement de l'image Hermes.
- Partie 03 : Vault et NGINX, version durcie.
- Partie 04 : Les cerveaux de Roger, LM Studio sur Mac et GLM (Z.ai).
- Partie 05 : Dépendances Xen Orchestra, Telegram et Obsidian.
- Partie 06 : Mise en œuvre de Roger, de l'image jusqu'aux premiers échanges sur Telegram.
- Partie 07 : Garde-fous, audit, exploitation et réutilisation.
Toutes les configurations seront versionnées au fil de l'eau dans un dépôt Git dédié, sans aucun secret.
Conclusion
Voilà pour la présentation. Hermes semble apporter la maturité qui manquait à OpenClaw, en particulier sur la sécurité, mais il ne dispense pas de construire un environnement d'exécution solide autour de lui. C'est tout l'objet de cette série.
Roger va être plus ambitieux que It-claw : une nouvelle cible avec Xen Orchestra, deux sources de LLM, une base de connaissances avec Obsidian, et une vraie réflexion sur l’exploitation. À la fin, on devrait disposer d’une méthode réutilisable pour créer d’autres agents spécialisés, ce qui a toujours été mon objectif de départ.
Maintenant qu'on sait où on va, il n'y a plus qu'à préparer la VM. Rendez-vous dans le prochain article à paraitre bientôt.